 Clickl Petroleoegas
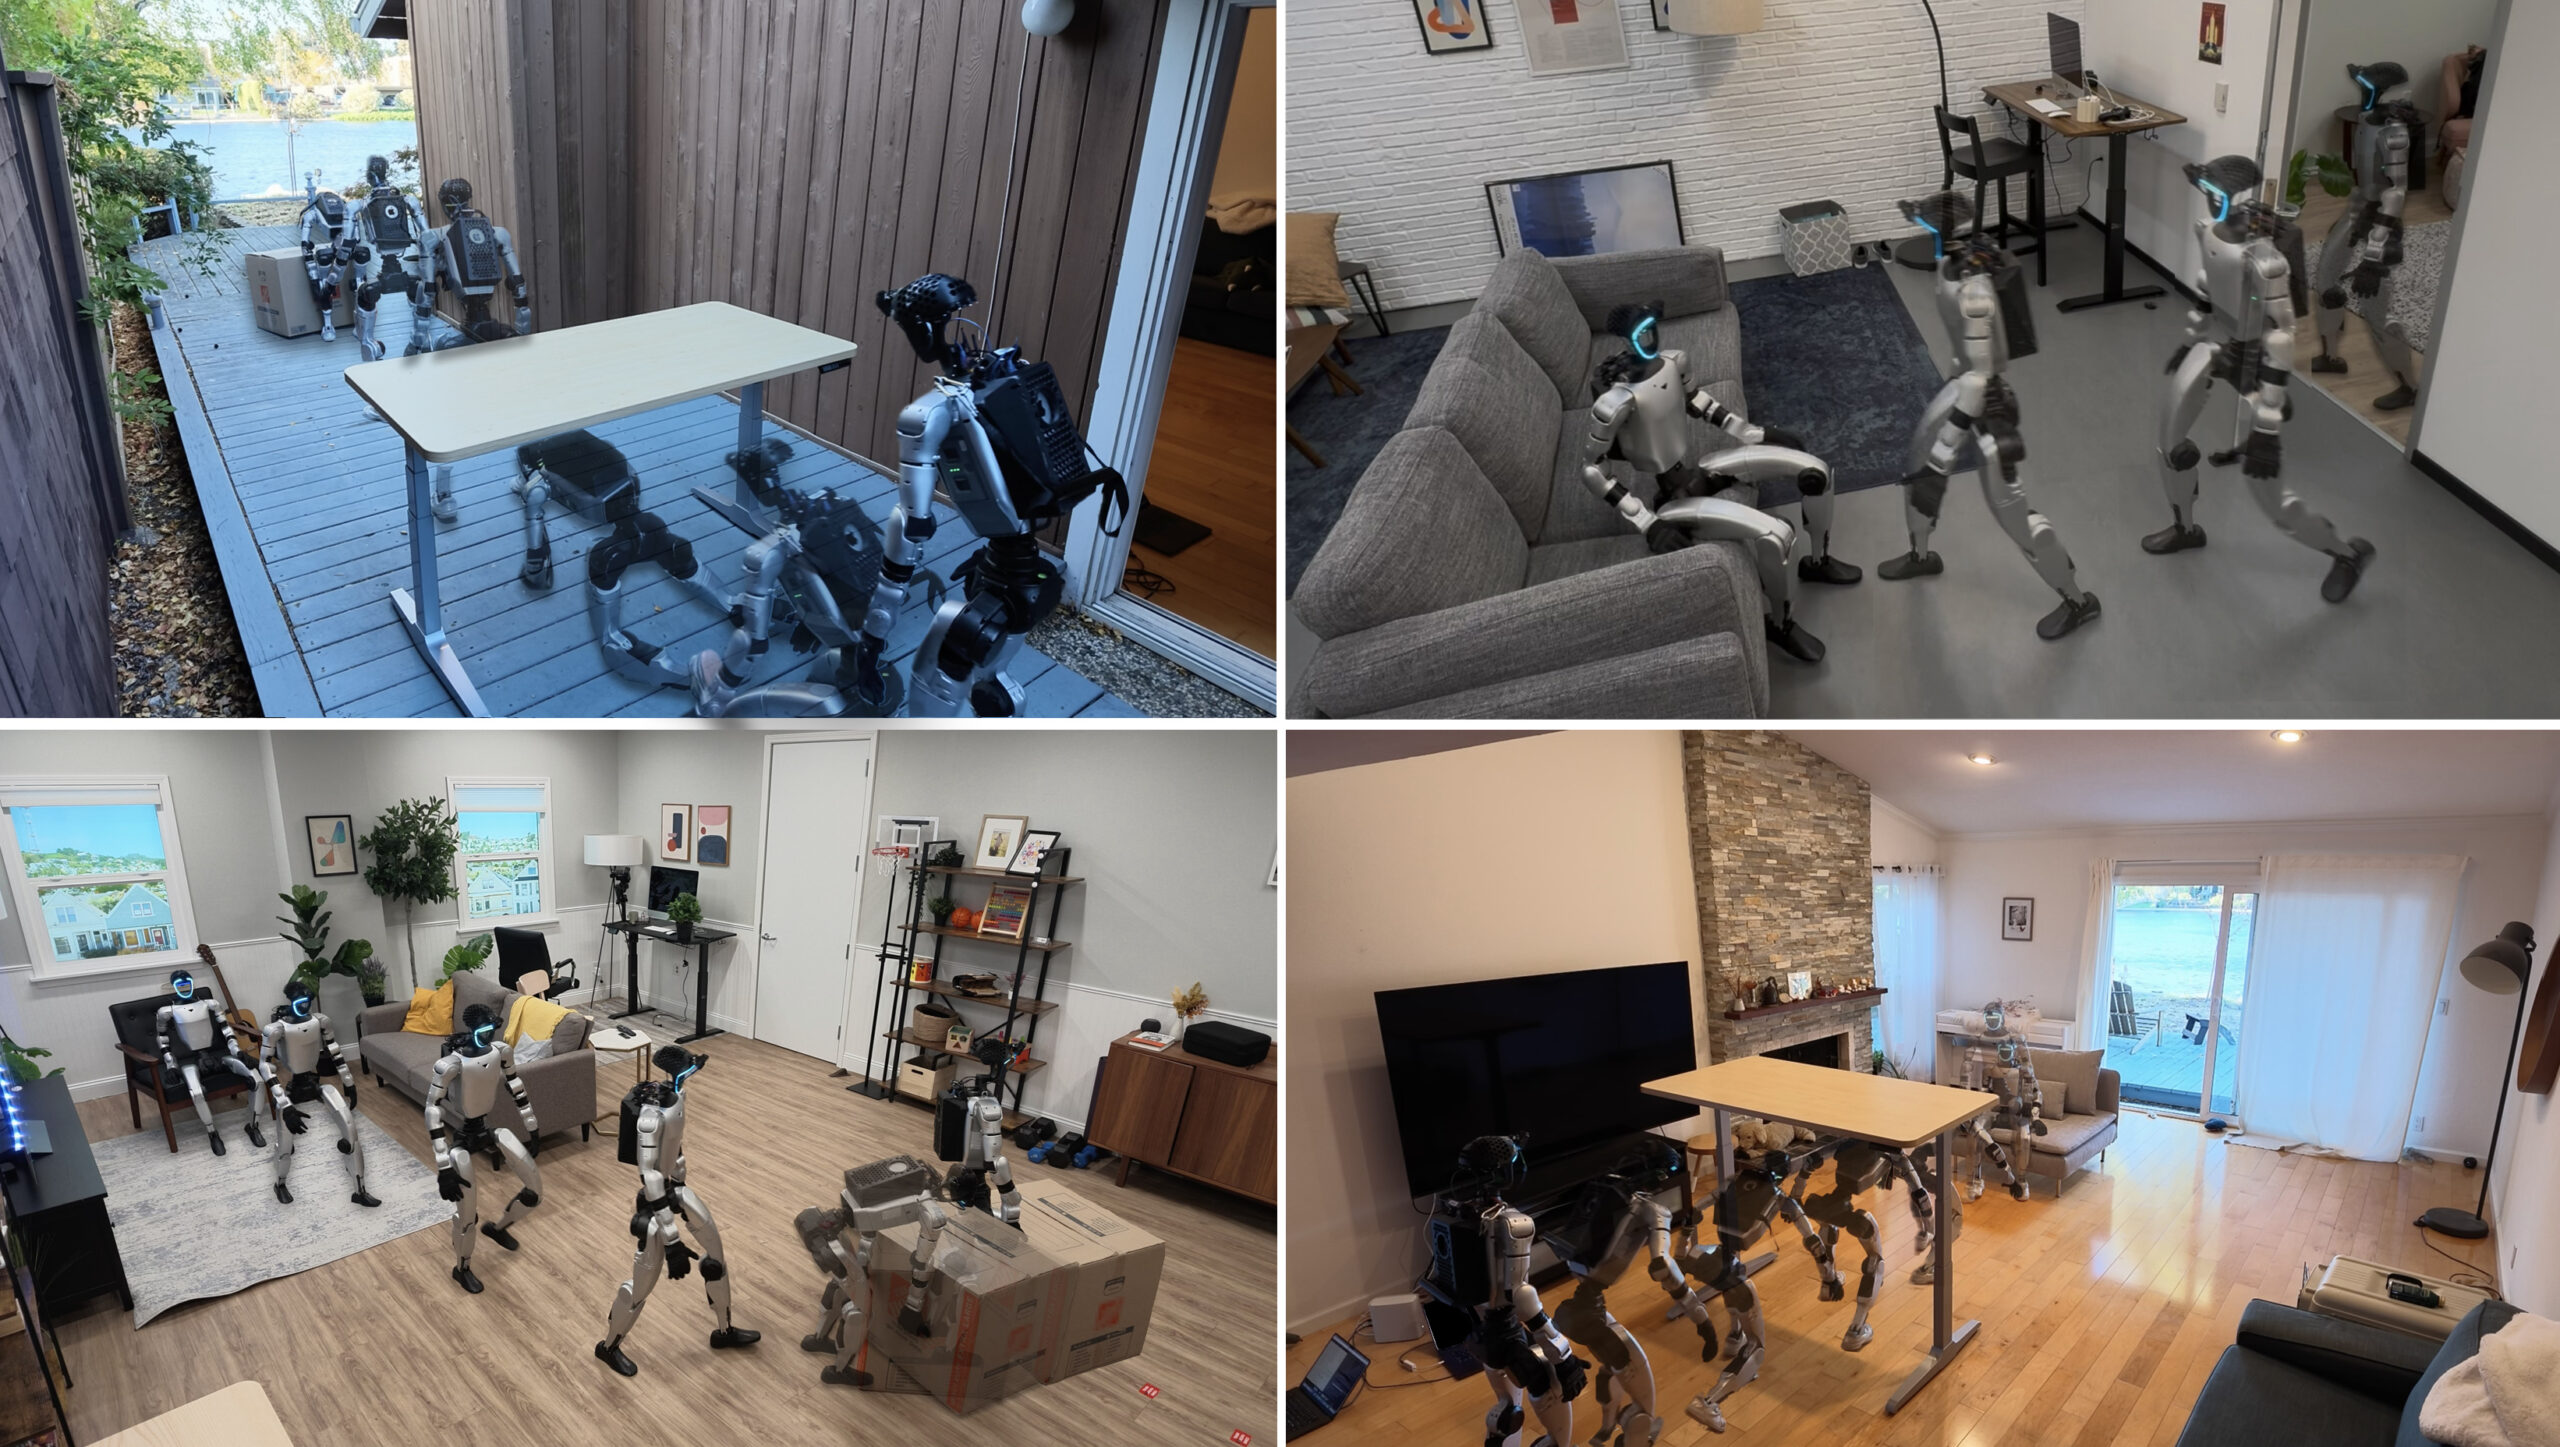
Um robô humanoide foi treinado em mil casas que não existem fisicamente e depois colocado em seis ambientes reais que nunca havia visitado. O resultado divulgado por pesquisadores da Apple foi de 91% de sucesso em 360 tentativas de movimentos específicos: sentar em uma cadeira, passar por portas parcialmente abertas, se agachar, rastejar sob mesas, empurrar caixas e caminhar até objetos indicados.
O experimento, apresentado em um estudo científico disponibilizado em 4 de novembro de 2026, usou um robô Unitree G1 equipado com câmeras e um computador adicional. Chamado HALO, o sistema aprendeu movimentos com imagens, instruções e simulações de residências geradas por computador.
Quando precisou combinar várias tarefas em sequência, a taxa média de acerto caiu para 70%, revelando a diferença entre executar um movimento e realizar uma atividade doméstica completa. Em vez de visitar residências com um operador humano, a equipe construiu espaços virtuais com paredes, portas, sofás, camas, mesas e diferentes distribuições de móveis.
Um programa de criação de ambientes, chamado Infinigen, gerou mil cenários variados para o treinamento. Os pesquisadores então posicionaram movimentos nessas cenas e criaram imagens semelhantes àquelas captadas pela câmera do próprio robô.
O HALO recebeu aproximadamente 300 horas de exemplos digitais de movimentos associados a comandos e imagens. Entre os exercícios estavam aproximar-se de uma cadeira para sentar, passar por uma abertura estreita e se abaixar para atravessar um espaço sob a mesa.
O conjunto foi produzido em escala: o estudo descreve cerca de 162 mil episódios simulados, preparados para mostrar ao sistema diferentes combinações de posições e obstáculos. O modelo de movimento não precisava decorar uma planta específica.
Durante o treinamento, mesas mudavam de posição, portas surgiam com aberturas diferentes e a iluminação podia variar. Essa diversidade ajudou o sistema a reconhecer situações parecidas quando encontrou móveis de verdade, em ambientes que não haviam sido escaneados ou mapeados previamente.
Os pesquisadores avaliaram seis habilidades em seis ambientes físicos, repetindo cada tipo de tarefa dez vezes em cada local. O robô obteve 100% de sucesso ao se agachar sob obstáculos, 93% ao passar de lado por portas entreabertas e 92% ao caminhar até um objeto indicado.
Rastejar sob uma mesa teve 90% de acertos; empurrar uma caixa, 88%; e sentar numa cadeira, 85%. Somadas as 360 tentativas, a média registrada foi de 91%.
Para a equipe, uma tarefa contava como bem-sucedida quando o equipamento conseguia concluí-la sem cair nem ficar preso. A avaliação também foi repetida em ambientes virtuais reservados, que não faziam parte das casas usadas no treinamento, e apresentou a mesma média de 91% para essas habilidades.
Os vídeos divulgados pelos autores mostram o Unitree G1 contornando móveis e ajustando a postura ao encontrar obstáculos. As imagens da demonstração oficial do HALO documentam a passagem entre movimentos simulados e deslocamentos físicos do robô em cômodos desconhecidos.
A situação mudou quando o robô precisou cumprir instruções que exigiam mais de um movimento. Em 30 testes de três sequências, realizados em um ambiente real, a média foi de 70% de sucesso.
Passar por uma porta e ir até um objeto funcionou nas dez tentativas. Agachar e depois sentar deu certo em 60% dos casos.
A sequência mais difícil exigia agachar, caminhar até uma caixa e empurrá-la: a taxa caiu para 50%. Em parte das falhas, o robô terminava o agachamento virado para o lado oposto ao objeto.
Sem conseguir enxergá-lo novamente, perdia o rumo da etapa seguinte. Em outra sequência, chegou a procurar um sofá quando a instrução envolvia uma cadeira.
Esses erros ajudam a definir o estágio da tecnologia. O HALO executa um repertório delimitado de habilidades e consegue encadeá-las em algumas condições, mas ainda precisa localizar melhor objetos que saem do campo de visão e corrigir sua trajetória quando uma etapa termina em posição desfavorável.
O robô escolhido foi um Unitree G1 modificado. A equipe instalou uma câmera na cabeça e um Mac mini M4 Pro na parte traseira para processar imagens e instruções.
Uma segunda câmera de profundidade ajudava a estimar as distâncias e a geometria à frente do corpo. Todo o sistema de controle utilizado nos testes funcionava a bordo do robô, sem depender de alguém pilotando cada movimento por controle remoto.
O software divide o trabalho em três níveis. Primeiro, interpreta pedidos em linguagem natural, como passar por uma porta e sentar.
Depois, monta um plano de movimento que considera a imagem captada. Por fim, um controlador ajusta o corpo e envia comandos para as 29 articulações monitoradas, levando em conta a posição das pernas, o equilíbrio e a distância dos obstáculos.
O robô revisa o planejamento durante a execução: a parte responsável pelos movimentos prepara trajetórias de cinco segundos e atualiza o plano várias vezes por segundo, enquanto o controlador físico faz ajustes mais rápidos. Isso permite reagir quando a cadeira está um pouco diferente do que o sistema esperava, mesmo sem um mapa pronto da sala.
O estudo descreve uma infraestrutura de processamento expressiva para gerar os dados sintéticos. A preparação do conjunto principal consumiu aproximadamente 48 horas em 250 processadores gráficos NVIDIA H100.
Outras máquinas especializadas foram usadas para treinar os modelos que planejam e controlam os movimentos. O método reduz a necessidade de um ser humano conduzir repetidamente um robô real para gravar exemplos, mas a criação de novas habilidades ainda demanda participação dos pesquisadores.
Alguém precisa definir os comandos e fornecer referências de postura e movimento para novas tarefas. A equipe também aproveitou registros anteriores de movimentos humanos em etapas do desenvolvimento.
Em um teste específico feito em simulação, reduzir a diversidade do treinamento para apenas uma casa derrubou o sucesso da tarefa de sentar para 43%. Com mil ambientes, a taxa chegou a 84% nessa mesma avaliação.
O resultado mostra por que variar o espaço virtual é importante quando o destino final são cômodos desconhecidos. Os autores reconhecem limites claros: o sistema depende principalmente de visão e ainda não dispõe de percepção tátil direta para confirmar contatos.
Suas tarefas avaliadas envolveram locomoção, postura e empurrar objetos; não demonstraram a capacidade de pegar utensílios pequenos, lavar louça ou arrumar uma casa inteira de forma independente. O trabalho também foi divulgado como pré-publicação científica no arXiv, e os resultados apresentados são os da equipe responsável, sem uma reprodução independente descrita no estudo.
Os pesquisadores disponibilizaram demonstrações e código do projeto, mas não anunciaram um robô doméstico da Apple pronto para comercialização. O próximo desafio é ampliar as habilidades e melhorar a recuperação quando um objeto desaparece da câmera.
Enquanto isso, os testes já mostram um humanoide aprendendo movimentos em casas inventadas por computador e aplicando parte desse aprendizado em residências reais. Você confiaria em um robô treinado dessa maneira para circular sozinho pela sua casa? Conte sua opinião nos comentários.